H200からBlackwell Ultraへ:Nvidiaの次世代AIチップ
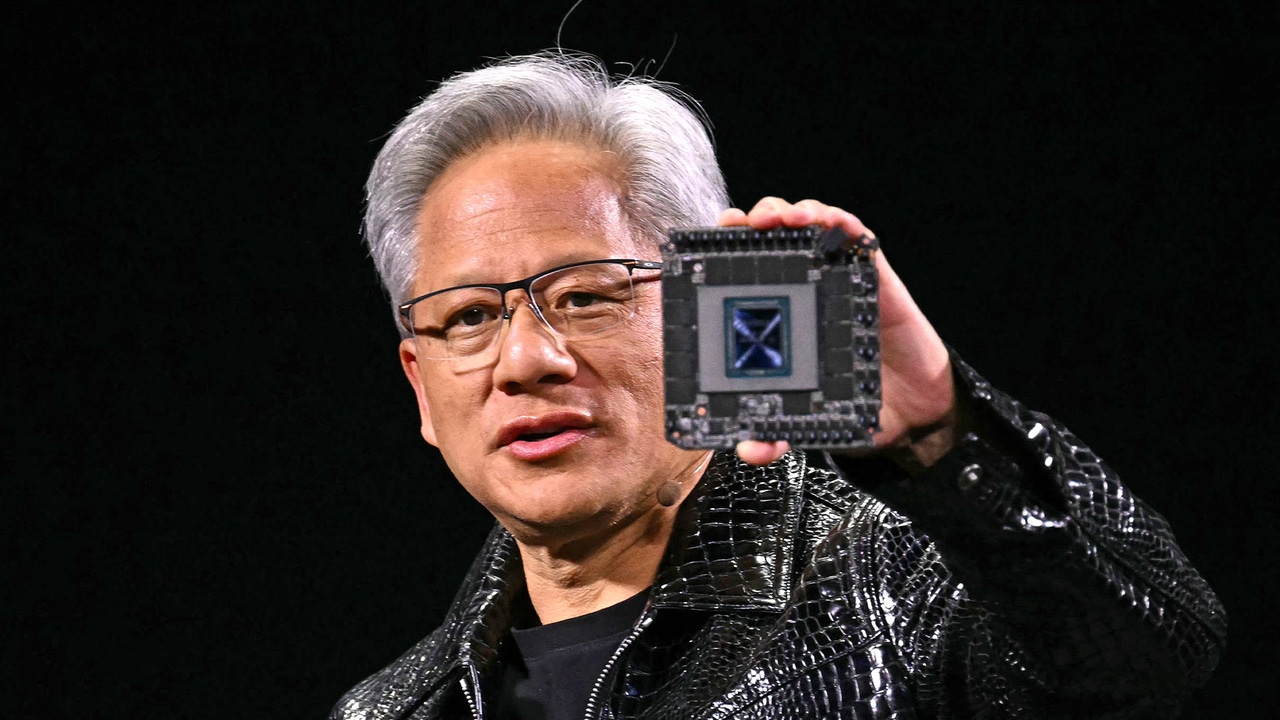
H200はNvidiaの最新AIチップではありません。Nvidiaはこれを2023年11月に発表し、2024年半ばから市場に出回っています。2025年5月末現在、Nvidiaの次のチップはBlackwell Ultraであり、3月のGTCカンファレンスで発表され、2025年後半にパートナーから提供される予定です。それぞれのチップがどのようなもので、Nvidiaがそれに対してどのような主張をしているのかを測定します。
H200: 2023年からのメモリアップグレード
Nvidiaは2023年11月13日にSC23スーパーコンピューティングカンファレンスでH200を紹介しました。これはH100と同じアーキテクチャであるHopper上に構築されています。変更点はメモリです。NvidiaはこれをHBM3eを搭載した最初のGPUと呼んでおり、4.8テラバイト毎秒で141GBを持っています。これはH100の容量のほぼ2倍で、メモリ帯域幅は1.4倍です。
「倍増」という主張は1つのテストから来ています。Nvidiaは、70億パラメータの言語モデルであるLlama 2の推論速度がH100と比較してほぼ倍増すると述べ、その製品ページでは1.9倍としています。エネルギーについて、Nvidiaはより効率が良いと主張し、消費電力が低いとは言っていません。「H100と同じ電力プロファイル内で」その利点が得られると述べています。
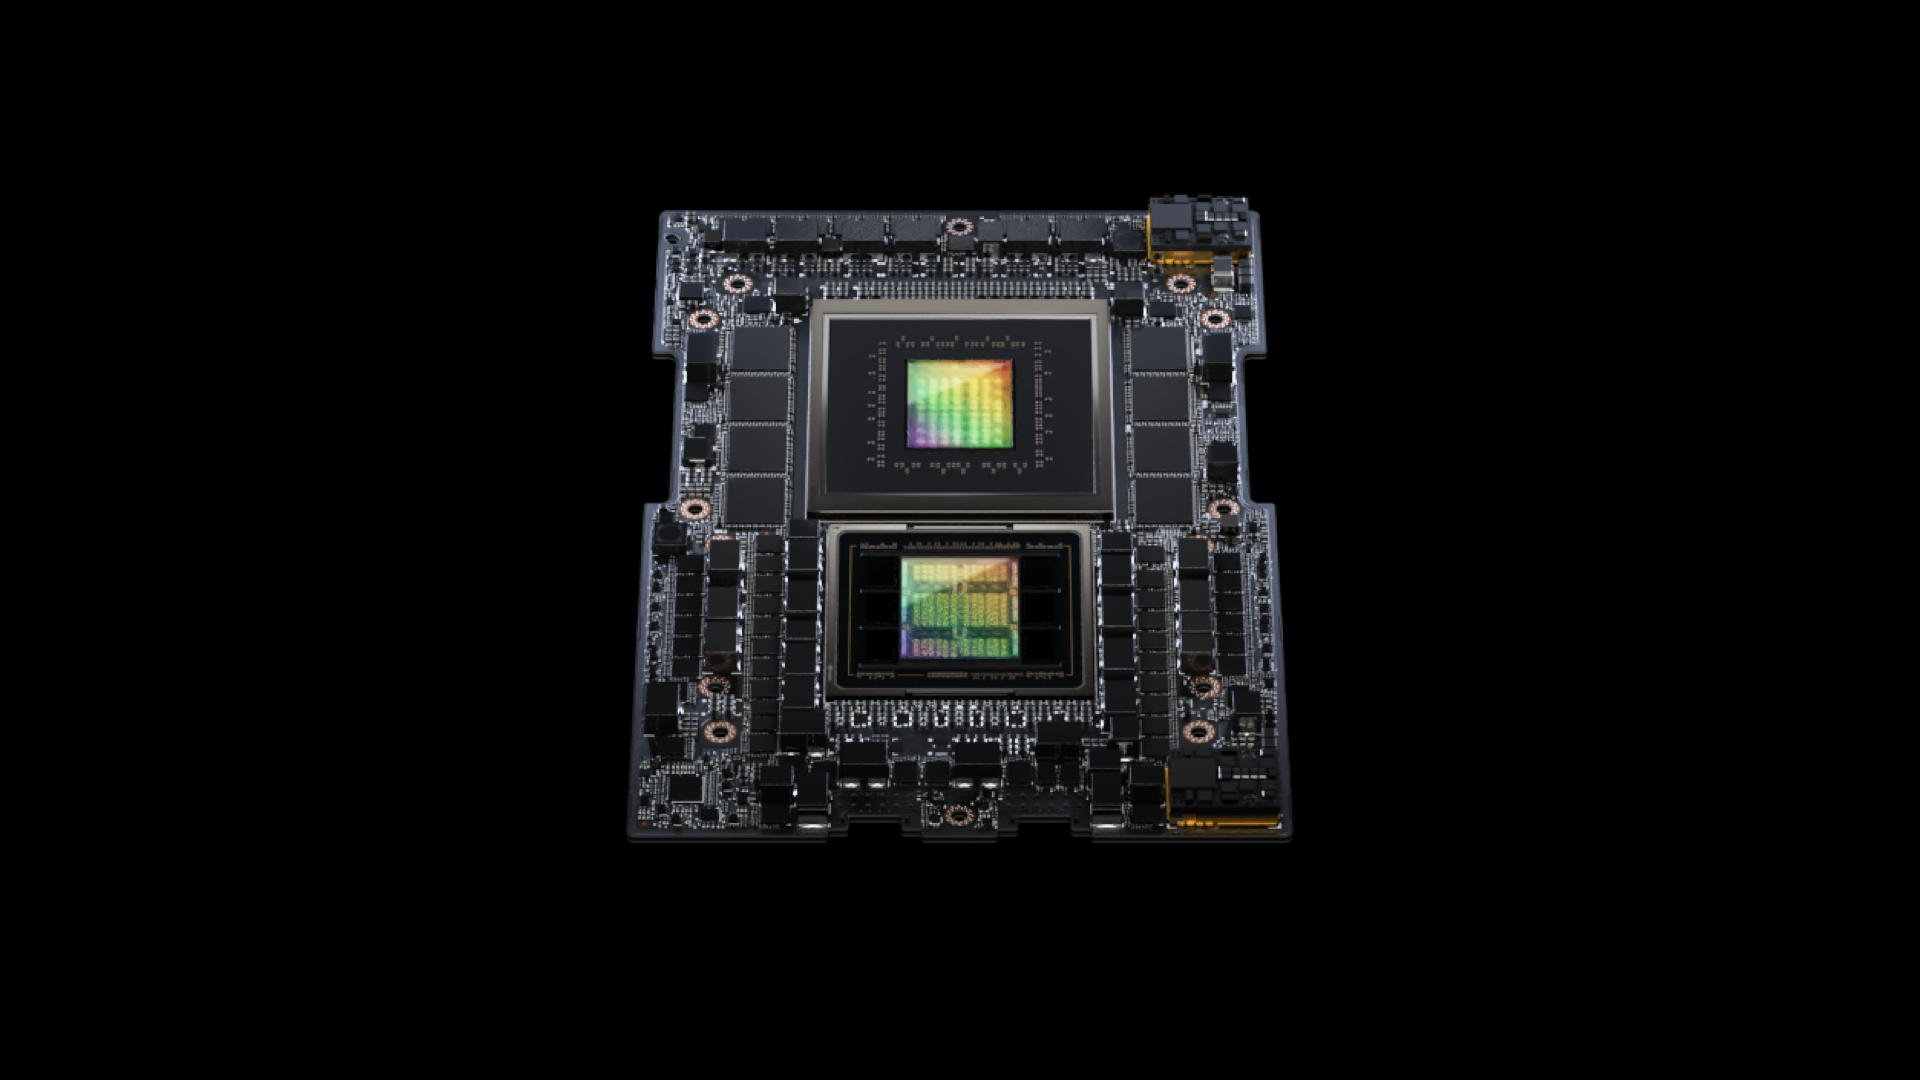
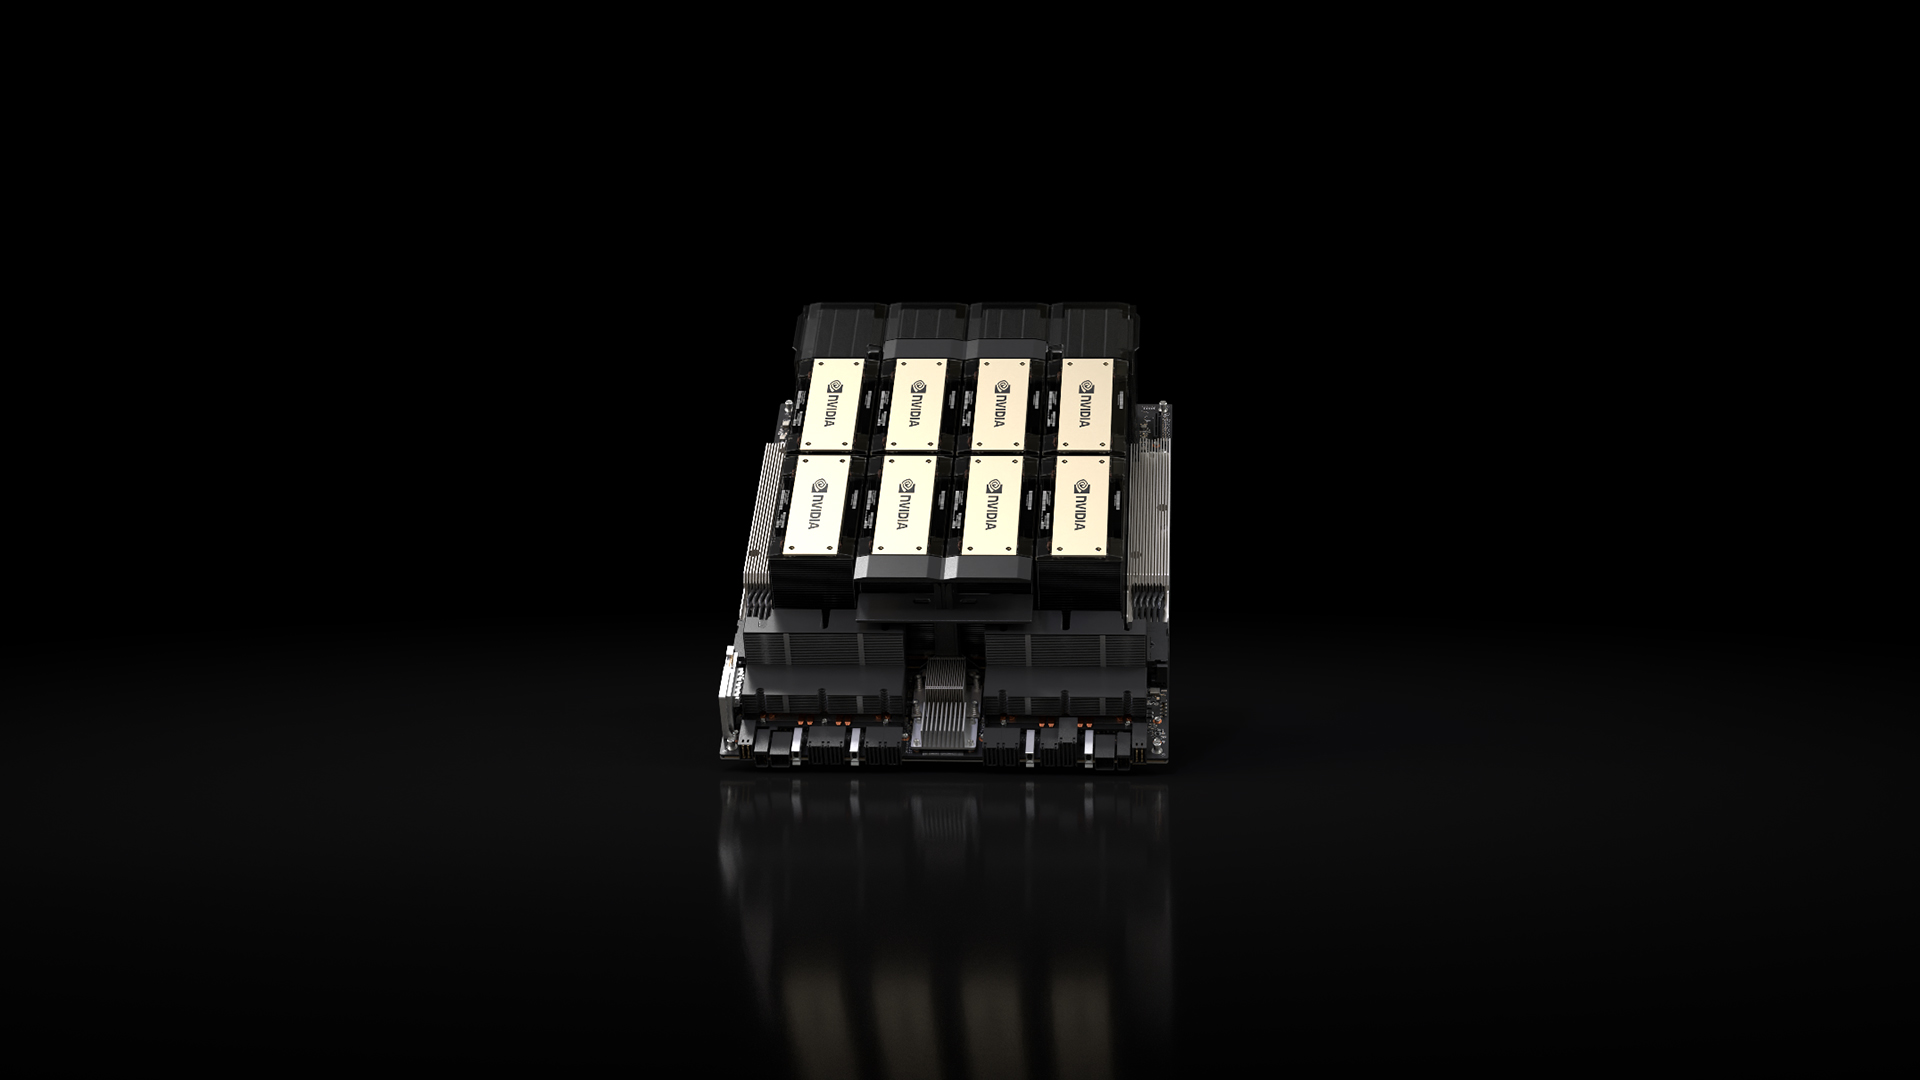
HGX H200サーバーボードは4つまたは8つのGPUを保持し、HGX H100システムと互換性があるため、サーバーメーカーは既存のマシンを更新することができます。
同じGPUは、NvidiaのGrace CPUと1つのモジュールでペアを組む、2023年8月に発表されたHBM3eを搭載したGH200 Grace Hopper Superchipにも搭載されています。2024年8月までに、CoreWeaveが一般提供を発表した最初のクラウドプロバイダーとなりました。
Blackwell: 次世代への道
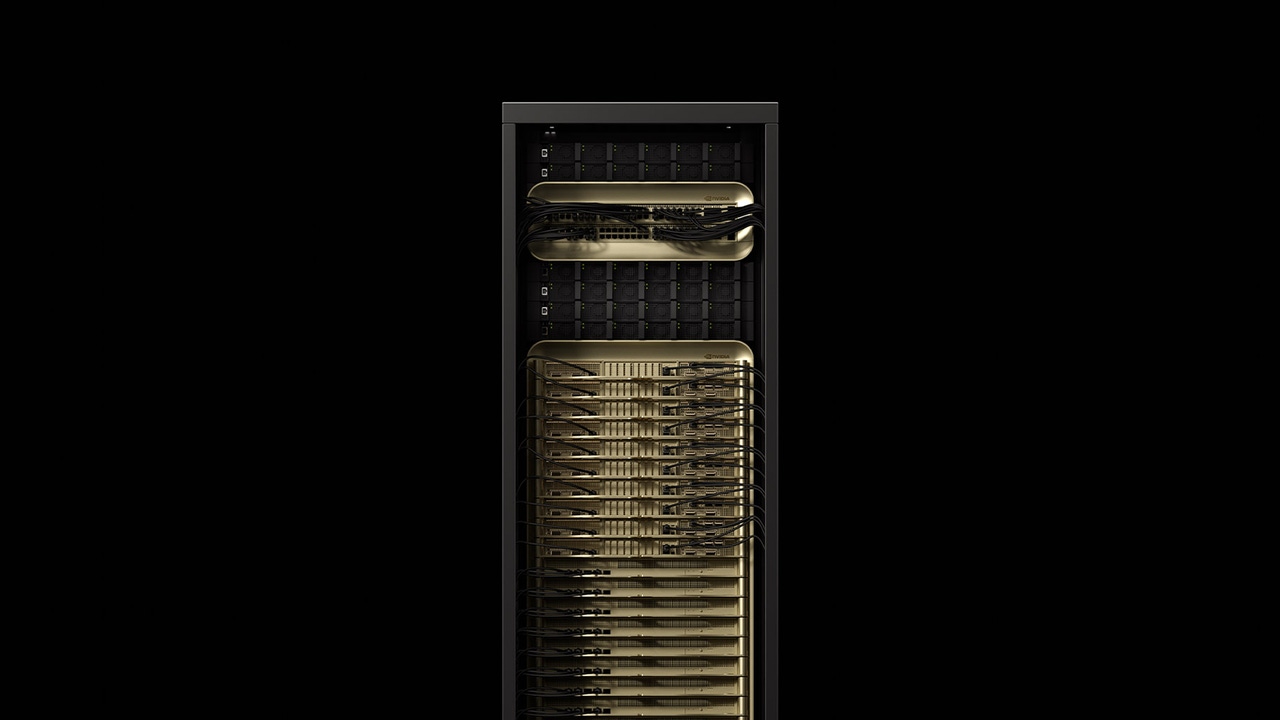
Hopperの真の後継者はBlackwellであり、2024年3月18日にGTCで発表されました。そのフラッグシップシステムである液冷GB200 NVL72は、1つのラックで72のBlackwell GPUと36のGrace CPUをリンクしています。Nvidiaは、同数のH100 GPUに対してLLM推論で30倍の性能を提供し、コストとエネルギー使用量を最大25倍削減すると述べています。これらは1つの作業負荷タイプに対する最良のケースの数値であり、エネルギーの主張はH200ではなくBlackwellに属しています。
2025年5月28日にNvidiaが第1四半期の結果を報告した際、CEOのJensen Huangは、Blackwell NVL72システムが「システムメーカーとクラウドサービスプロバイダーでの大規模生産に入った」と述べました。この報告には、米国政府がNvidiaのH20チップの中国への輸出にライセンスを要求したことによる45億ドルの費用も示されていました。
2025年にNvidiaが発表したもの:Blackwell Ultra
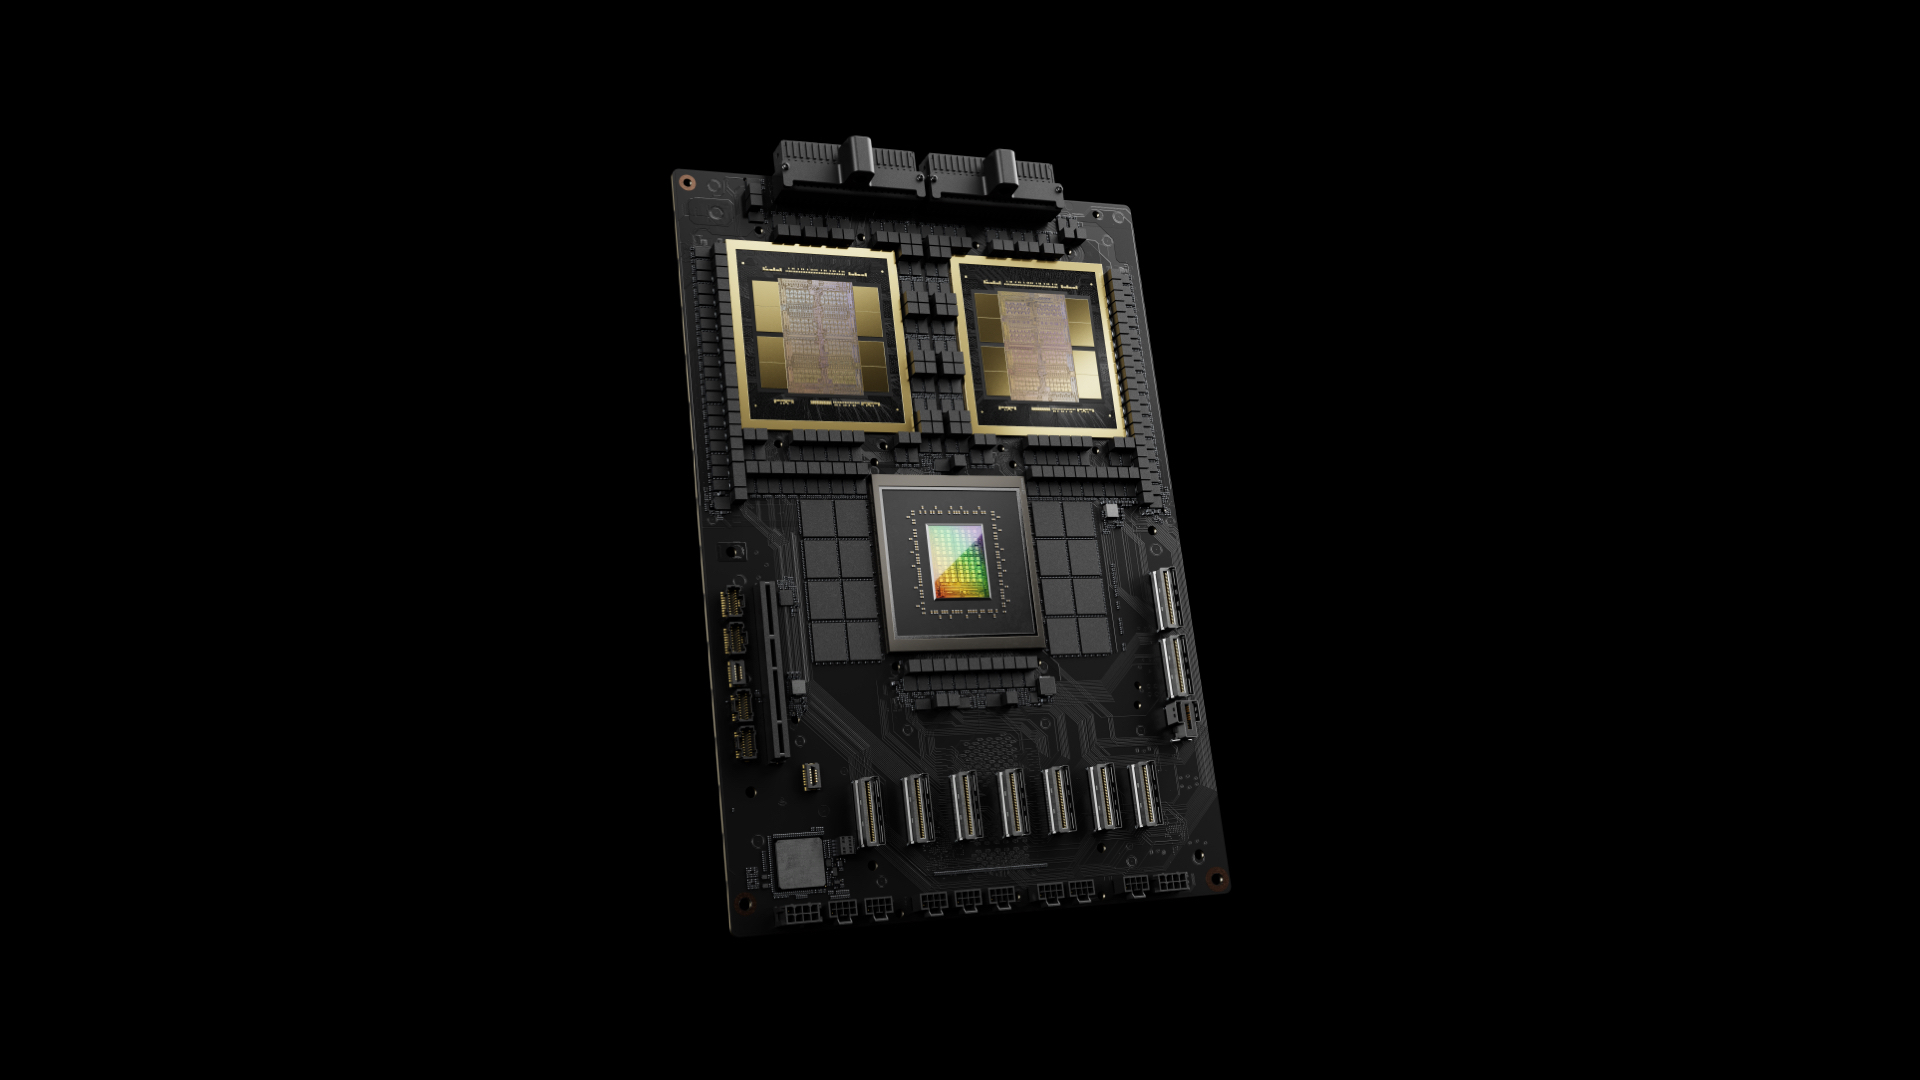
2025年3月18日にサンノゼで開催されたGTCで、NvidiaはBlackwellプラットフォームの次のステップであるBlackwell Ultraを発表しました。GB300 NVL72ラックは72のBlackwell Ultra GPUと36のGrace CPUを接続し、Nvidiaの発表によればGB200 NVL72の1.5倍のAI性能を提供します。Nvidiaによれば、HGX B300 NVL16サーバーは、Hopper世代に比べてLLM推論が11倍速く、計算能力が7倍、メモリが4倍大きくなっています。TechCrunchの報告によれば、チップごとのメモリはBlackwellの192GBから288GBに増加しています。
「AIは大きな飛躍を遂げました。推論およびエージェントAIは、桁違いに多くの計算性能を要求しています」とHuangは述べました。Nvidiaはまた、GB300 NVL72はHopperと比較してAIファクトリーの収益機会を50倍に引き上げると主張しました。これはビジネスの見積もりであり、速度テストではありません。
Nvidiaは、2025年後半からパートナーからのBlackwell Ultra製品を期待しています。5月19日に台北で開催されたComputexで、HuangはGB300システムを紹介し、PCMagはこれが第3四半期に発売される予定であると報じました。また、Huangはパートナー独自のCPUやカスタムチップにNvidiaのNVLinkインターコネクトを開放するNVLink Fusionも紹介しました。
3月のGTCで、Huangはその後のロードマップも示しました:2026年後半に新しいNvidia CPU「Vera」とペアを組むRubin GPUを備えたVera Rubin、2027年後半にRubin Ultra、2028年にFeynmanというアーキテクチャです。

Nvidiaの性能主張を読む方法
- ベースラインを確認しましょう。 H200の「ほぼ倍増」は、Llama 2推論テスト1つに対するH100との比較です。GB300 NVL72の1.5倍は、前のBlackwellラックに対するものです。30倍と11倍の数値はHopperに対するものです。それぞれの数字は異なる質問に対する答えです。
- メモリが多くの役割を果たしています。 H200はH100のHopper設計を維持し、より大きく高速なメモリから利益を得ました。Blackwell Ultraもまた、チップごとのメモリを288GBに引き上げています。大規模なモデルを実行するためには、メモリがしばしばペースを設定します。
- 発表は提供開始ではありません。 H200は2023年11月に発表され、2024年半ばにクラウドに到達しました。Blackwell Ultraは2025年3月に発表され、年後半に登場予定です。購入者はキーノートではなく出荷日を基に計画を立てます。
更新情報:その後の展開(2026年10月)
この記事は2025年5月28日に初めて公開されました。その後の展開は以下の通りです:
- 2025年8月: Nvidiaの第2四半期の結果で、Huangは「Blackwell Ultraの生産はフルスピードで加速しており、需要は非常に高い」と引用されました。同社は四半期中に中国ベースの顧客へのH20販売を報告しませんでした。
- 2025年12月: トランプ大統領は、Nvidiaが中国の承認された顧客にH200チップを出荷することを許可するとし、25%を米国に支払う必要があると述べました。Blackwellと今後のRubinチップは除外されました。
- 2026年1月: 1月5日のCESで、NvidiaはRubinプラットフォームを発表し、Rubin GPUとVera CPUを含む6つの新チップを発表し、パートナープロダクトは2026年後半に予定されています。NvidiaはBlackwellに比べて推論コストをトークン当たり最大10倍低くすると主張しました。同月、H200の中国への販売が条件付きで正式に承認されました。
- 2026年3月: 3月16日のGTCで、NvidiaはVera Rubinプラットフォームが7つのチップをフル生産していると述べ、新たに推論用のGroq 3 LPUを追加しました。Huangは次のアーキテクチャとして新しいCPU「Rosa」を搭載したFeynmanを名づけ、2025年から2027年までの収益を少なくとも1兆ドルと見込んでいると述べました。
- 2026年4月から8月: H200の中国への販売が停滞しました。4月22日、商務長官のHoward Lutnickは上院の公聴会で、「まだ彼らにチップを販売していない」と述べました。7月、商務省の職員は「非常に少量のチップ」が出荷されたと述べました。8月、Financial TimesはByteDanceとTencentがそれぞれ約10,000のH200を受け取ったと報じました。
- 2026年8月: Nvidiaは四半期の収益を962億ドルと報告し、Vera Rubinがフル生産に入っており、CoreWeave、Google Cloud、Microsoft Azure、Oracle Cloud Infrastructure、Nebiusでラックが稼働していると述べました。その見通しは依然として中国からのデータセンターコンピュート収益を考慮していませんでした。
2026年末までには、H200はNvidiaの最新システムから2世代遅れており、その最大の話題は速度ではなく、輸出政策に関するものでした。
出典
- NVIDIA: NVIDIAがHopperを強化し、H200を発表(2023年11月13日)
- NVIDIA: H200 GPU製品ページ
- NVIDIA: HBM3eを搭載したGH200 Grace Hopper Superchip(2023年8月8日)
- NVIDIA: 第2四半期2025年度の結果、CoreWeaveでのH200(2024年8月28日)
- NVIDIA: Blackwellプラットフォームが登場(2024年3月18日)
- NVIDIA: 第1四半期2026年度の結果(2025年5月28日)
- NVIDIA: Blackwell Ultra AIファクトリープラットフォーム(2025年3月18日)
- TechCrunch: Blackwell Ultra、Vera Rubin、FeynmanはNvidiaの次のGPU(2025年3月18日)
- NVIDIA: NVLink Fusion(2025年5月18日)
- PCMag via Yahoo Tech: NvidiaがComputex 2025の基調講演で明らかにしたすべてのこと(2025年5月19日)
- NVIDIA: 第2四半期2026年度の結果(2025年8月27日)
- The Register: トランプ大統領、NvidiaがH200を中国に販売できると発言(2025年12月9日)
- NVIDIA: CESでのRubinプラットフォームの発表(2026年1月5日)
- NVIDIA: Vera RubinがエージェントAIのフロンティアを開く(2026年3月16日)
- NVIDIA Blog: GTC 2026ライブ更新(2026年3月19日)
- The Standard, from Reuters: Nvidiaはまだ中国にH200チップを販売していないとLutnickが発言(2026年4月23日)
- CNBC: 「非常に少数」のNvidia H200チップが中国に出荷された(2026年7月14日)
- Tom's Hardware, citing the Financial Times: 最初のH200出荷が中国に到着(2026年8月19日)
- NVIDIA: 第2四半期2027年度の結果(2026年8月26日)
週刊インサイトを購読する
AI、SEO、Growth Marketing に関する週刊インサイトをメールでお届けします。スパムなし、役立つ内容だけ。
購読を希望されませんか?同じインサイトを得てつながるにはLinkedInでフォローしてください